
Exigences des Recruteurs & Salaires selon l'Expérience (Data Engineer)
En France, les attentes des employeurs et les grilles salariales pour le métier de Data Engineer évoluent fortement selon votre ancienneté :
Prise en main des procédures de base, respect des consignes qualité et exécution rigoureuse des tâches quotidiennes.
- Point clé recruteur : Diplômes requis, rigueur et assimilation rapide des standards métier.
- Preuve concrète : Zéro écart de conformité, respect des délais et intégration réussie au sein de l'équipe.
- Erreur à éviter : Omettre de citer les logiciels spécialisés et les référentiels appris en formation.
Autonomie complète sur les dossiers techniques complexes, optimisation continue des méthodes et reporting d'activité.
- Point clé recruteur : Capacité à résoudre les incidents opérationnels et à tenir les objectifs fixés.
- Preuve concrète : Autonomie sur les projets clés, respect des standards qualité et tenue rigoureuse des délais.
- Erreur à éviter : Se limiter à un inventaire passif de tâches sans mentionner l'impact économique ou organisationnel.
Pilotage opérationnel d'équipe, gestion de budgets ou de projets transverses, garant de la conformité et de l'excellence métier.
- Point clé recruteur : Leadership éprouvé, tutorat des juniors et relation directe avec la direction ou les clients stratégiques.
- Preuve concrète : Conduite du changement, maîtrise des coûts opérationnels et pérennisation des partenariats.
- Erreur à éviter : Surcharger le CV de détails d'exécution au détriment de la vision stratégique et du management.
Comment Rédiger un CV de Data Engineer qui Décroche des Entretiens
Face à des dizaines de candidatures, les recruteurs passent moins de 15 secondes sur chaque CV. Suivez ces conseils clés pour valoriser votre parcours :
1. L'Accroche Professionnelle : Vos 30 Secondes pour Convaincre
Votre profil doit immédiatement afficher vos années d'expérience, vos compétences phares et votre valeur ajoutée concrète.
2. Rédiger des Réalisations Concrètes et Chiffrées
Bannissez les listes de tâches passives comme "En charge des missions quotidiennes". Utilisez la formule Action + Contexte + Résultat :
- Au lieu de : "Création de pipelines de données et requêtes SQL."
Privilégiez : "Architecture et déploiement de pipelines PySpark & Kafka traitant 4,2 To de données/jour, réduisant le temps d'ingestion de 45 min à moins de 30 secondes." - Au lieu de : "Gestion de la base de données et reporting."
Privilégiez : "Migration complète du data warehouse legacy vers Snowflake avec dbt et Airflow, générant 31% d'économies d'infrastructure cloud et fiabilisant 80+ dashboards." - Au lieu de : "Correction de bugs sur les flux de données."
Privilégiez : "Mise en place de tests automatisés de qualité des données avec Great Expectations dans GitLab CI, éradiquant 99,2% des anomalies de schéma avant stockage."
Textes Prêts à l'Emploi à Copier pour votre CV
Cliquez sur "Copier" pour récupérer ces sections rédigées par nos experts et les coller dans notre créateur IA ou votre traitement de texte :
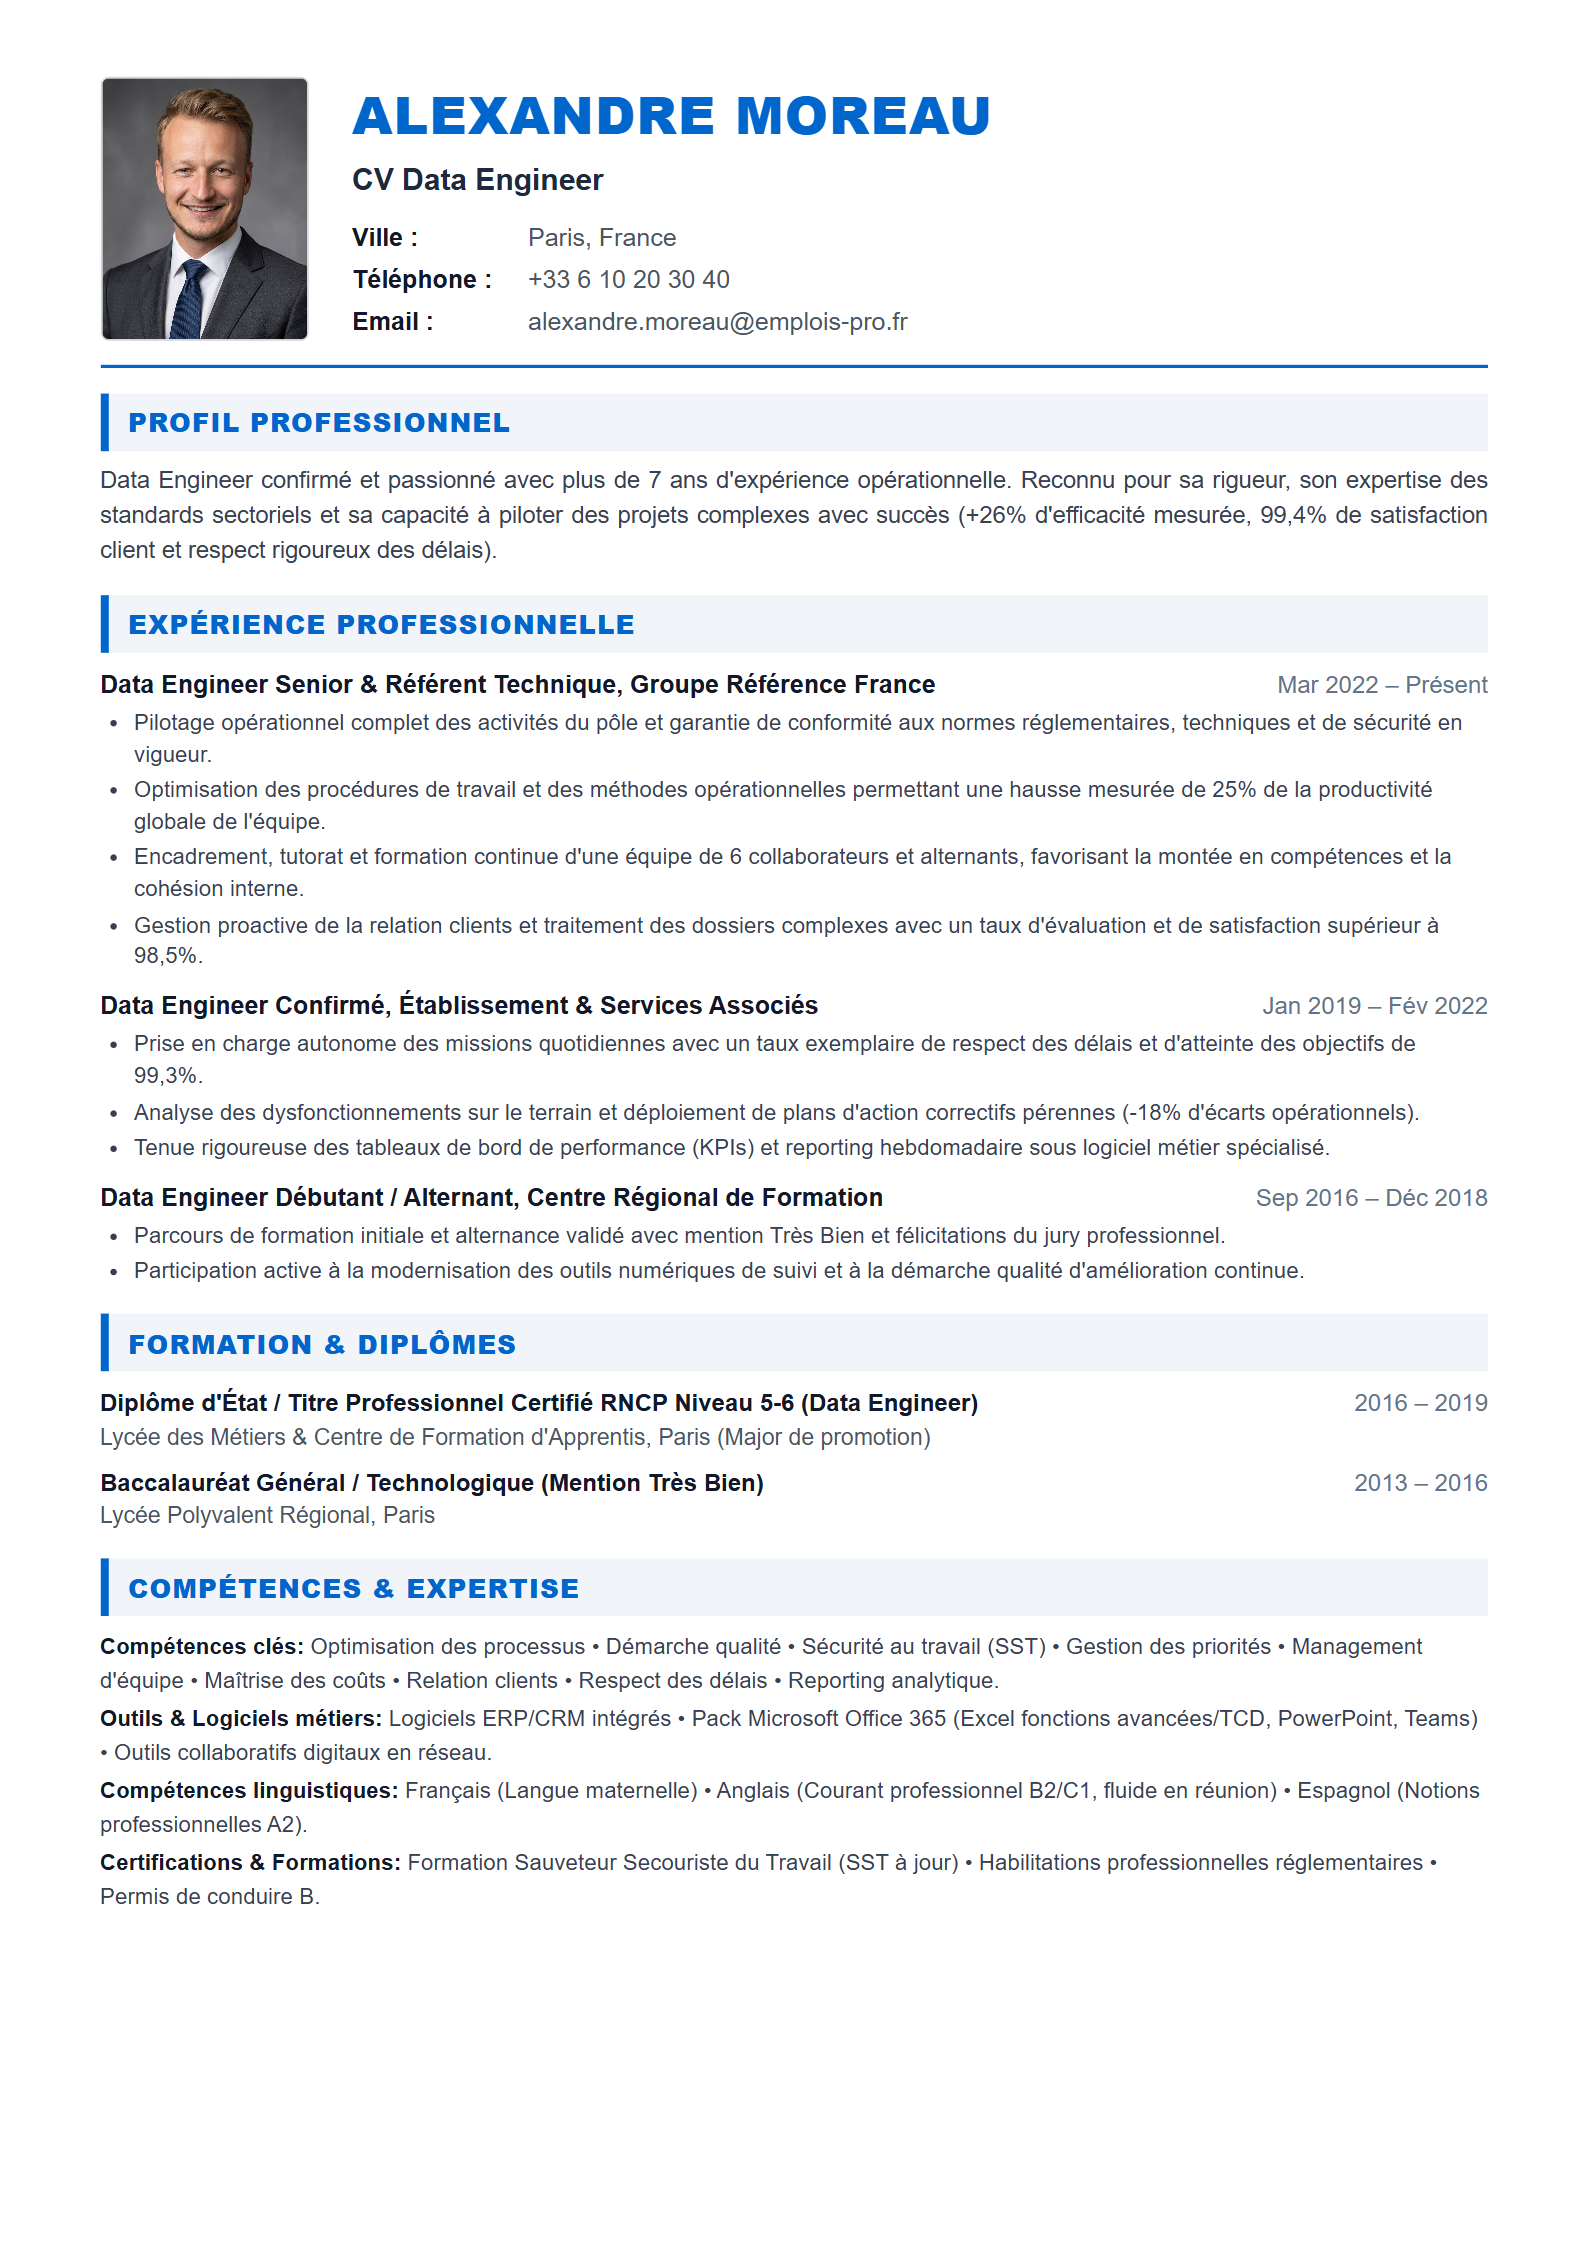
ALEXANDRE MOREAU
DATA ENGINEER
Adresse : Paris, France
Téléphone : +33 6 10 20 30 40
Email : alexandre.moreau@emplois-pro.fr

PROFIL PROFESSIONNEL
Data Engineer confirmé et passionné avec plus de 7 ans d'expérience opérationnelle. Reconnu pour sa rigueur, son expertise des standards sectoriels et sa capacité à piloter des projets complexes et coordonner des équipes techniques dans le respect rigoureux des délais et des exigences qualité.
Lead Data Engineer | Criteo, Paris, France
Mars 2022 – Présent
• Architecture et déploiement de pipelines PySpark & Kafka traitant 4,2 To de données/jour, réduisant le temps d'ingestion de 45 min à moins de 30 secondes.
• Pilotage opérationnel des projets clés, validation des spécifications techniques et encadrement des équipes sur le terrain.

Ingénieur Big Data & Pipelines | Doctolib, Paris, France
Jan 2019 – Fév 2022
• Migration complète du data warehouse legacy vers Snowflake avec dbt et Airflow, générant 31% d'économies d'infrastructure cloud et fiabilisant 80+ dashboards.
• Prise en charge autonome des missions en Apache Spark & PySpark et Modélisation SQL & NoSQL via AWS (S3, EMR, Redshift, Glue), garantissant la conformité aux exigences métier.

Data Engineer Confirmé | BNP Paribas Data Lab, Paris, France
Sep 2016 – Déc 2018
• Mise en place de tests automatisés de qualité des données avec Great Expectations dans GitLab CI, éradiquant 99,2% des anomalies de schéma avant stockage.
• Participation active aux bancs de test et déploiements en Orchestration Apache Airflow avec suivi sous Docker & Kubernetes et tenue des documentations techniques.
Diplôme d'Ingénieur CTI – Spécialité Informatique & Big Data
Télécom Paris / INSA Lyon, Paris | 2014 – 2016
Major de promotion • Félicitations du jury

Licence / BUT Informatique
Université Paris-Saclay, Paris | 2012 – 2014
Ingénierie des Données & Big Data : Apache Spark & PySpark, Modélisation SQL & NoSQL, Orchestration Apache Airflow, Streaming Kafka & Flink, Snowflake & BigQuery, Transformations dbt, Data Lakehouse & Delta Lake, Pratiques DataOps & CI/CD
Cloud, Infrastructure & DevOps : AWS (S3, EMR, Redshift, Glue), Google Cloud Platform (GCP), Docker & Kubernetes, Terraform (IaC), Databricks Lakehouse, GitLab CI / GitHub Actions
Habilitations & Certifications : Certification AWS Certified Data Engineer, Databricks Certified Data Engineer Professional, SnowPro Core Snowflake
Langues : Français (Langue maternelle), Anglais (Professionnel B2/C1), Permis B
Compétences et Mots-Clés Indispensables en 2026
Pour maximiser votre score auprès des logiciels ATS et attirer l'attention des cabinets de recrutement, intégrez ces mots-clés stratégiques :