
Expectativas de Selección y Salarios para Ingeniero de Confiabilidad de Sitios (SRE)
En el mercado hispanohablante, las exigencias de contratación y las bandas retributivas para Ingeniero de Confiabilidad de Sitios (SRE) varían según la experiencia acumulada:
Dominio riguroso de las tareas operativas base, cumplimiento de protocolos de calidad y aprendizaje continuado.
- Punto clave reclutador: Titulación oficial acreditada, actitud resolutiva y asimilación rápida de la dinámica laboral.
- Prueba contrastada: 100% de fiabilidad en tareas asignadas y aprendizaje rápido de herramientas de software.
- Error a evitar: Omitir certificaciones académicas o prácticas formativas relevantes en el sector.
Autonomía completa en la resolución de incidencias complejas, optimización de procedimientos y reporte de actividad.
- Punto clave reclutador: Capacidad demostrada para liderar tareas críticas y elevar la calidad de servicio.
- Prueba contrastada: Optimización de procedimientos operativos, cumplimiento estricto de plazos y certificaciones técnicas.
- Error a evitar: Redactar listas de tareas sin asociar indicadores de mejora o volumen de trabajo gestionado.
Liderazgo de equipos de trabajo, interlocución con clientes estratégicos o dirección, control presupuestario y calidad.
- Punto clave reclutador: Visión integral del negocio, mentoring de perfiles junior y gestión del cambio.
- Prueba contrastada: Dirección técnica de equipos multidisciplinares, gestión presupuestaria y auditorías conformes.
- Error a evitar: Saturar el currículum con detalles operativos en lugar de destacar liderazgo y resultados estratégicos.
Guía de Redacción Paso a Paso: CV de Ingeniero de Confiabilidad de Sitios (SRE)
Los seleccionadores de talento dedican menos de 20 segundos a una primera criba. Sigue estas recomendaciones contrastadas para destacar:
1. El Perfil Profesional: Tu Carta de Presentación en 30 Segundos
Sintetiza tus años de experiencia, especialidad técnica principal y competencias clave en un párrafo conciso.
2. Redactar Logros Concretos y Relevantes
Evita redactar listas pasivas de obligaciones como "Responsable del trabajo diario". Utiliza el método STAR (Situación, Tarea, Acción, Resultado):
- En vez de: "Monitorización de servidores y resolución de caídas."
Mejor escribir: "Mantenimiento de disponibilidad del 99,995% en 180+ microservicios con 120.000 RPS, reduciendo el MTTR de 38 minutos a 4,2 minutos." - En vez de: "Automatización de despliegues."
Mejor escribir: "Diseño de pipeline GitOps autorreparable con ArgoCD y Terraform en Kubernetes, multiplicando por 5 la velocidad de despliegue a producción." - En vez de: "Informes tras incidentes de servicio."
Mejor escribir: "Implementación de pruebas de Chaos Engineering con Gremlin y post-mortems constructivos, resolviendo 18 puntos únicos de fallo antes de campañas de tráfico récord."
Textes Listos para Copiar en tu Currículum
Haz clic en "Copiar" para trasladar estos bloques de texto redactados por expertos directamente a nuestro creador IA o a tu editor de texto:
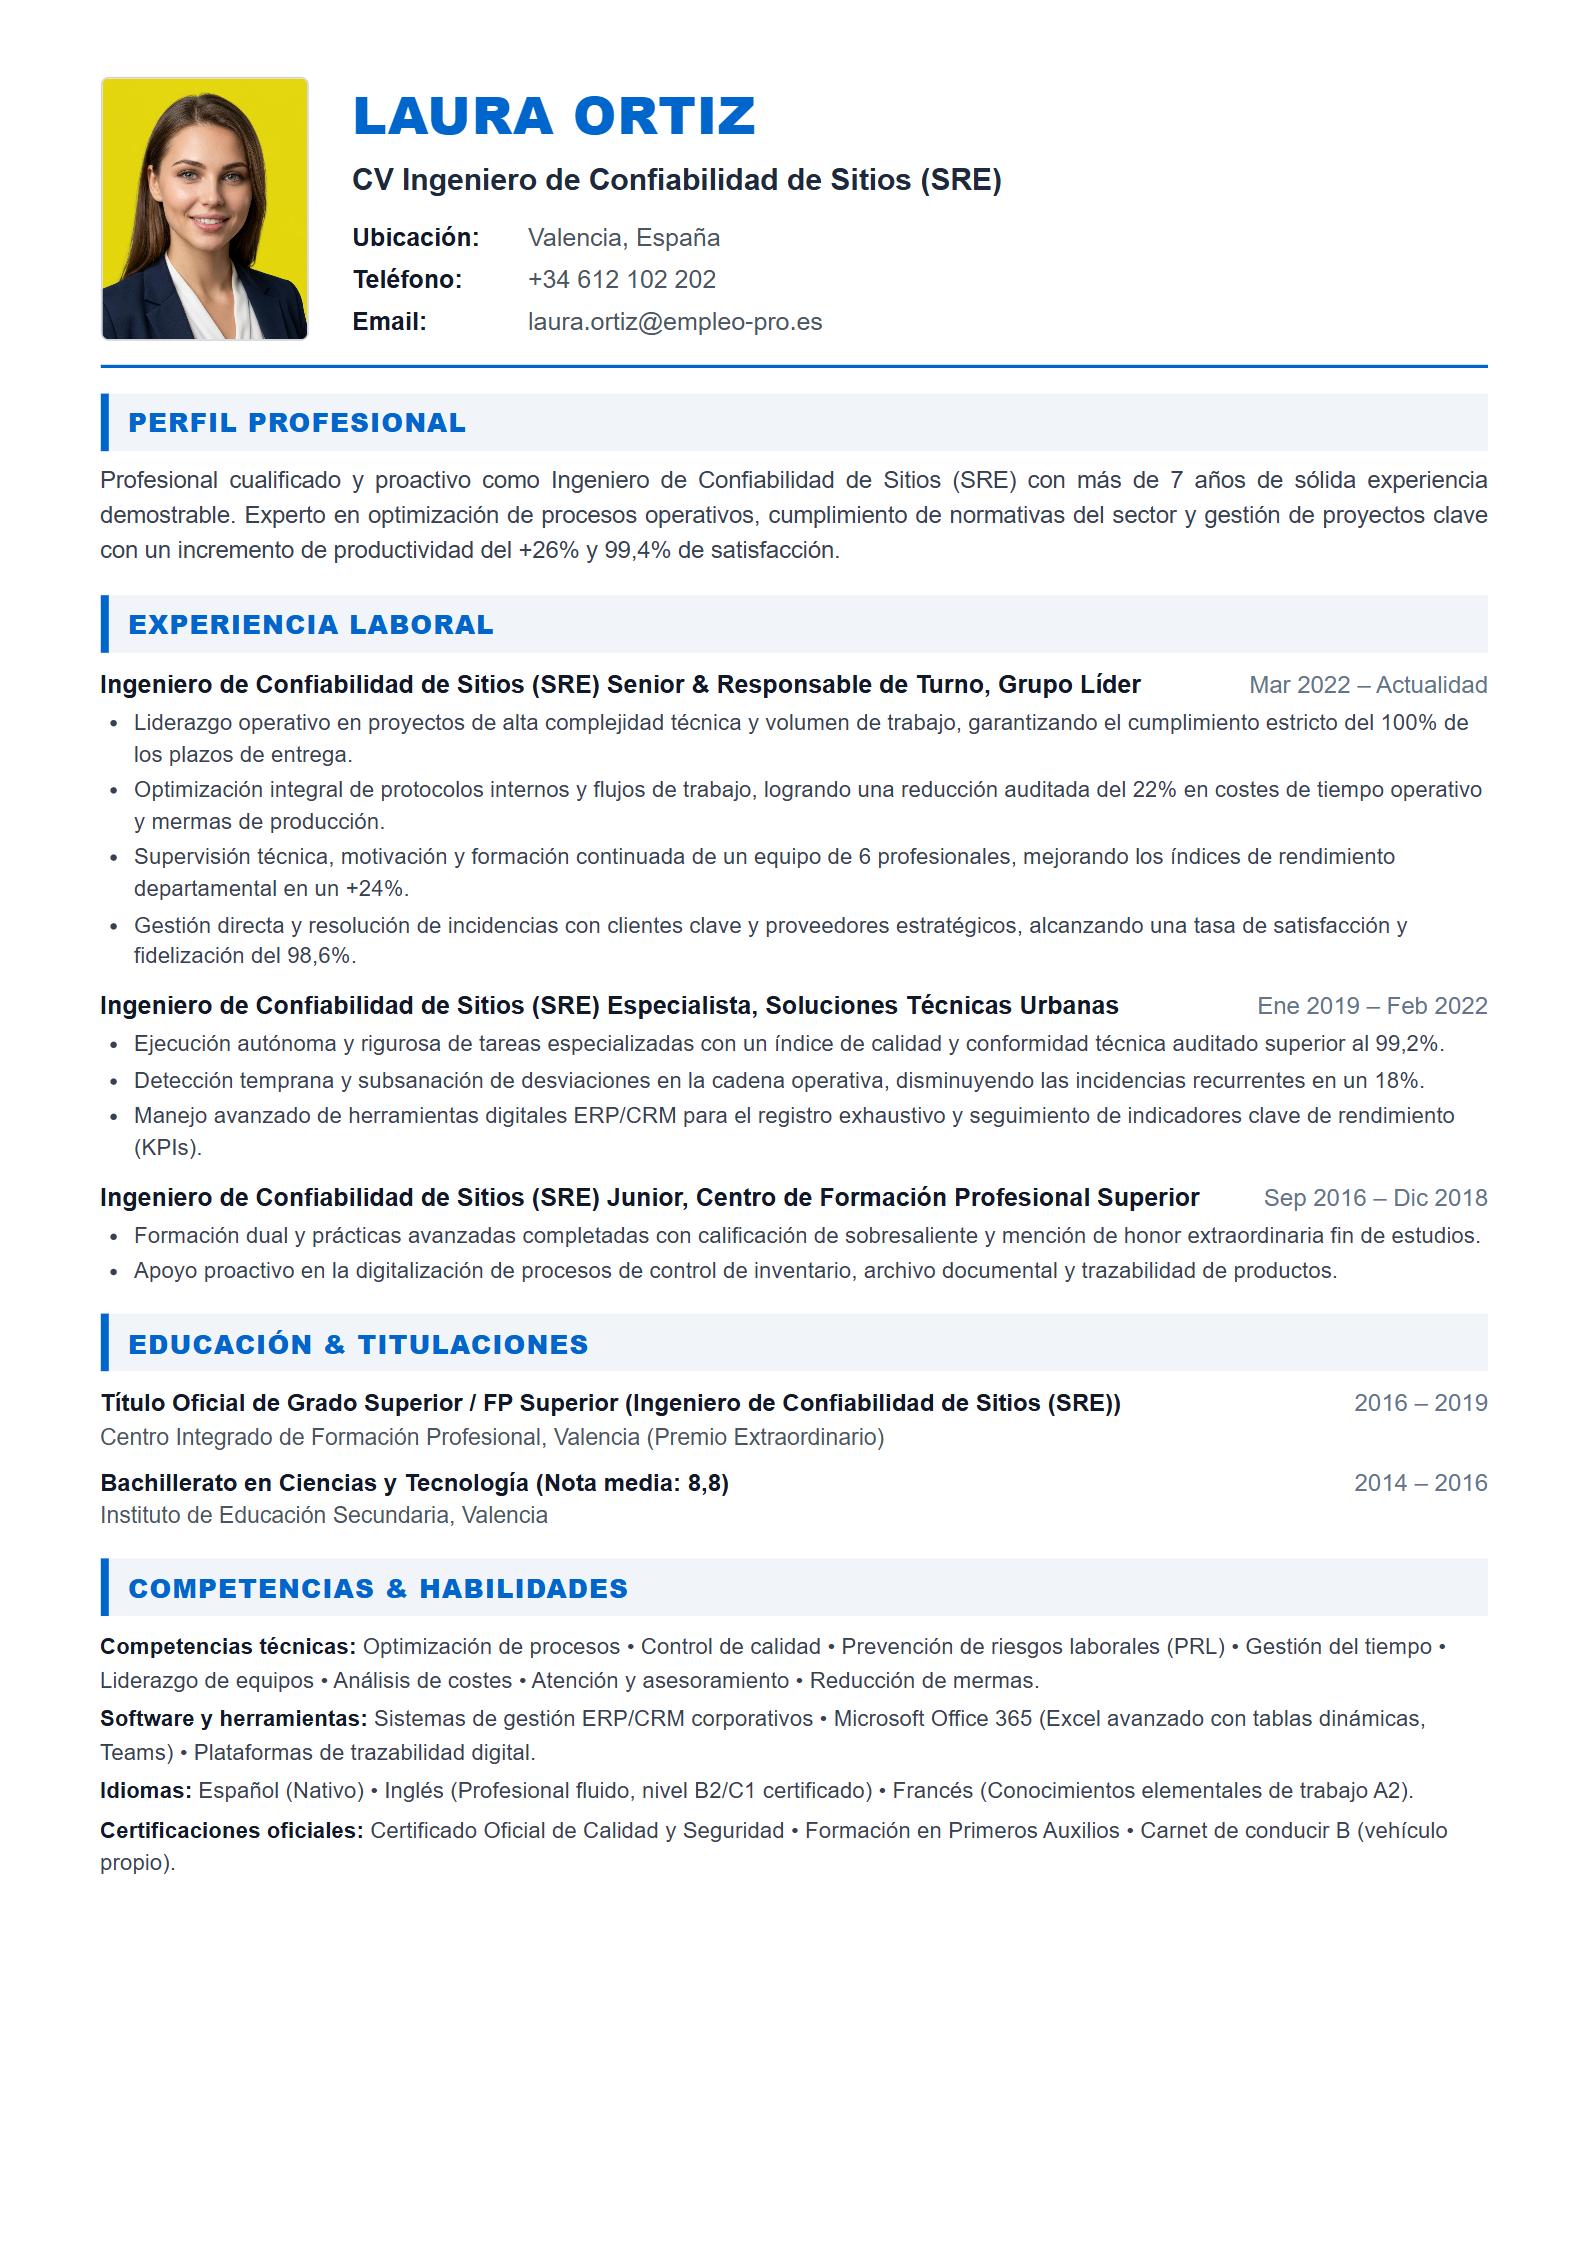
LAURA ORTIZ
INGENIERO DE CONFIABILIDAD DE SITIOS (SRE)
Dirección: Valencia, España, España
Teléfono: +34 612 102 202
Email: laura.ortiz@empleo-pro.es

PERFIL PROFESIONAL
Ingeniero de Confiabilidad de Sitios (SRE) cualificado y comprometido con más de 7 años de experiencia profesional demostrable. Especializado en la ejecución de proyectos complejos, aseguramiento de la calidad y coordinación de equipos técnicos conforme a las exigencias normativas del sector.
Site Reliability Engineer (SRE) Senior | Cabify, Valencia, España
Mar 2022 – Actualidad
• Mantenimiento de disponibilidad del 99,995% en 180+ microservicios con 120.000 RPS, reduciendo el MTTR de 38 minutos a 4,2 minutos.
• Dirección técnica de proyectos clave, validación de especificaciones y coordinación del equipo de trabajo en el terreno.

Ingeniero de Fiabilidad de Infraestructura | Wallapop, Valencia, España
Ene 2019 – Feb 2022
• Diseño de pipeline GitOps autorreparable con ArgoCD y Terraform en Kubernetes, multiplicando por 5 la velocidad de despliegue a producción.
• Ejecución autónoma de tareas especializadas en Gestión de Kubernetes y Service Mesh (Istio) y Monitorización con Prometheus y Grafana utilizando AWS y Google Cloud Platform con altos estándares de calidad.

Especialista DevOps & SRE | TravelPerk, Valencia, España
Sep 2016 – Dic 2018
• Implementación de pruebas de Chaos Engineering con Gremlin y post-mortems constructivos, resolviendo 18 puntos únicos de fallo antes de campañas de tráfico récord.
• Colaboración en pruebas técnicas y despliegues en Definición de SLI/SLO y Gestión de Error Budget con seguimiento bajo Trazabilidad con OpenTelemetry y Jaeger y elaboración de documentación.
Máster en Ciberseguridad y Redes de Computadores
Universidad Politécnica de Madrid (UPM), Valencia | 2014 – 2016
Premio Extraordinario Fin de Ciclo • Calificación Media: 9,4

Grado en Ingeniería Telemática / Informática
Universitat Autònoma de Barcelona (UAB), Valencia | 2012 – 2014
Fiabilidad de Sistemas & Observabilidad: Gestión de Kubernetes y Service Mesh (Istio), Monitorización con Prometheus y Grafana, Definición de SLI/SLO y Gestión de Error Budget, Optimización y Kernel de Linux, Gestión de Incidentes Críticos y Post-mortems, Ingeniería del Caos y Resiliencia, Terraform y GitOps, Desarrollo en Go y Python
Plataformas Cloud y Diagnóstico: AWS y Google Cloud Platform, Despliegue Continuo con ArgoCD, Trazabilidad con OpenTelemetry y Jaeger, Guardias e Incident Response (PagerDuty), Datadog y Stack ELK, Redes Avanzadas (BGP, DNS, TCP/IP)
Certificaciones & Normativa: Certified Kubernetes Administrator (CKA), AWS Certified DevOps Engineer Professional, Linux Certified System Administrator (LFCS)
Idiomas: Español (Nativo), Inglés (B2/C1 certificado), Carnet de conducir B
Competencias y Palabras Clave Estratégicas para 2026
Para superar los cribados automáticos de portales de empleo e IA de selección, integra estas palabras clave en tu perfil: