
Expectativas de Selección y Salarios para Data Engineer / Ingeniero de Datos
En el mercado hispanohablante, las exigencias de contratación y las bandas retributivas para Data Engineer / Ingeniero de Datos varían según la experiencia acumulada:
Dominio riguroso de las tareas operativas base, cumplimiento de protocolos de calidad y aprendizaje continuado.
- Punto clave reclutador: Titulación oficial acreditada, actitud resolutiva y asimilación rápida de la dinámica laboral.
- Prueba contrastada: 100% de fiabilidad en tareas asignadas y aprendizaje rápido de herramientas de software.
- Error a evitar: Omitir certificaciones académicas o prácticas formativas relevantes en el sector.
Autonomía completa en la resolución de incidencias complejas, optimización de procedimientos y reporte de actividad.
- Punto clave reclutador: Capacidad demostrada para liderar tareas críticas y elevar la calidad de servicio.
- Prueba contrastada: Optimización de procedimientos operativos, cumplimiento estricto de plazos y certificaciones técnicas.
- Error a evitar: Redactar listas de tareas sin asociar indicadores de mejora o volumen de trabajo gestionado.
Liderazgo de equipos de trabajo, interlocución con clientes estratégicos o dirección, control presupuestario y calidad.
- Punto clave reclutador: Visión integral del negocio, mentoring de perfiles junior y gestión del cambio.
- Prueba contrastada: Dirección técnica de equipos multidisciplinares, gestión presupuestaria y auditorías conformes.
- Error a evitar: Saturar el currículum con detalles operativos en lugar de destacar liderazgo y resultados estratégicos.
Guía de Redacción Paso a Paso: CV de Data Engineer / Ingeniero de Datos
Los seleccionadores de talento dedican menos de 20 segundos a una primera criba. Sigue estas recomendaciones contrastadas para destacar:
1. El Perfil Profesional: Tu Carta de Presentación en 30 Segundos
Sintetiza tus años de experiencia, especialidad técnica principal y competencias clave en un párrafo conciso.
2. Redactar Logros Concretos y Relevantes
Evita redactar listas pasivas de obligaciones como "Responsable del trabajo diario". Utiliza el método STAR (Situación, Tarea, Acción, Resultado):
- En vez de: "Creación de pipelines de datos y consultas SQL."
Mejor escribir: "Diseño e implementación de pipelines de streaming en PySpark y Kafka procesando 4,2 TB/día, reduciendo la latencia de ingestión de 45 min a menos de 30 segundos." - En vez de: "Mantenimiento del almacén de datos."
Mejor escribir: "Migración integral de DWH legacy a Snowflake mediante dbt y Airflow, recortando costes cloud en un 31% y respaldando a más de 80 analistas y científicos de datos." - En vez de: "Corrección de errores en cargas de datos."
Mejor escribir: "Automatización de validaciones de calidad de datos con Great Expectations en CI/CD, evitando el 99,2% de errores de esquema en producción."
Textes Listos para Copiar en tu Currículum
Haz clic en "Copiar" para trasladar estos bloques de texto redactados por expertos directamente a nuestro creador IA o a tu editor de texto:
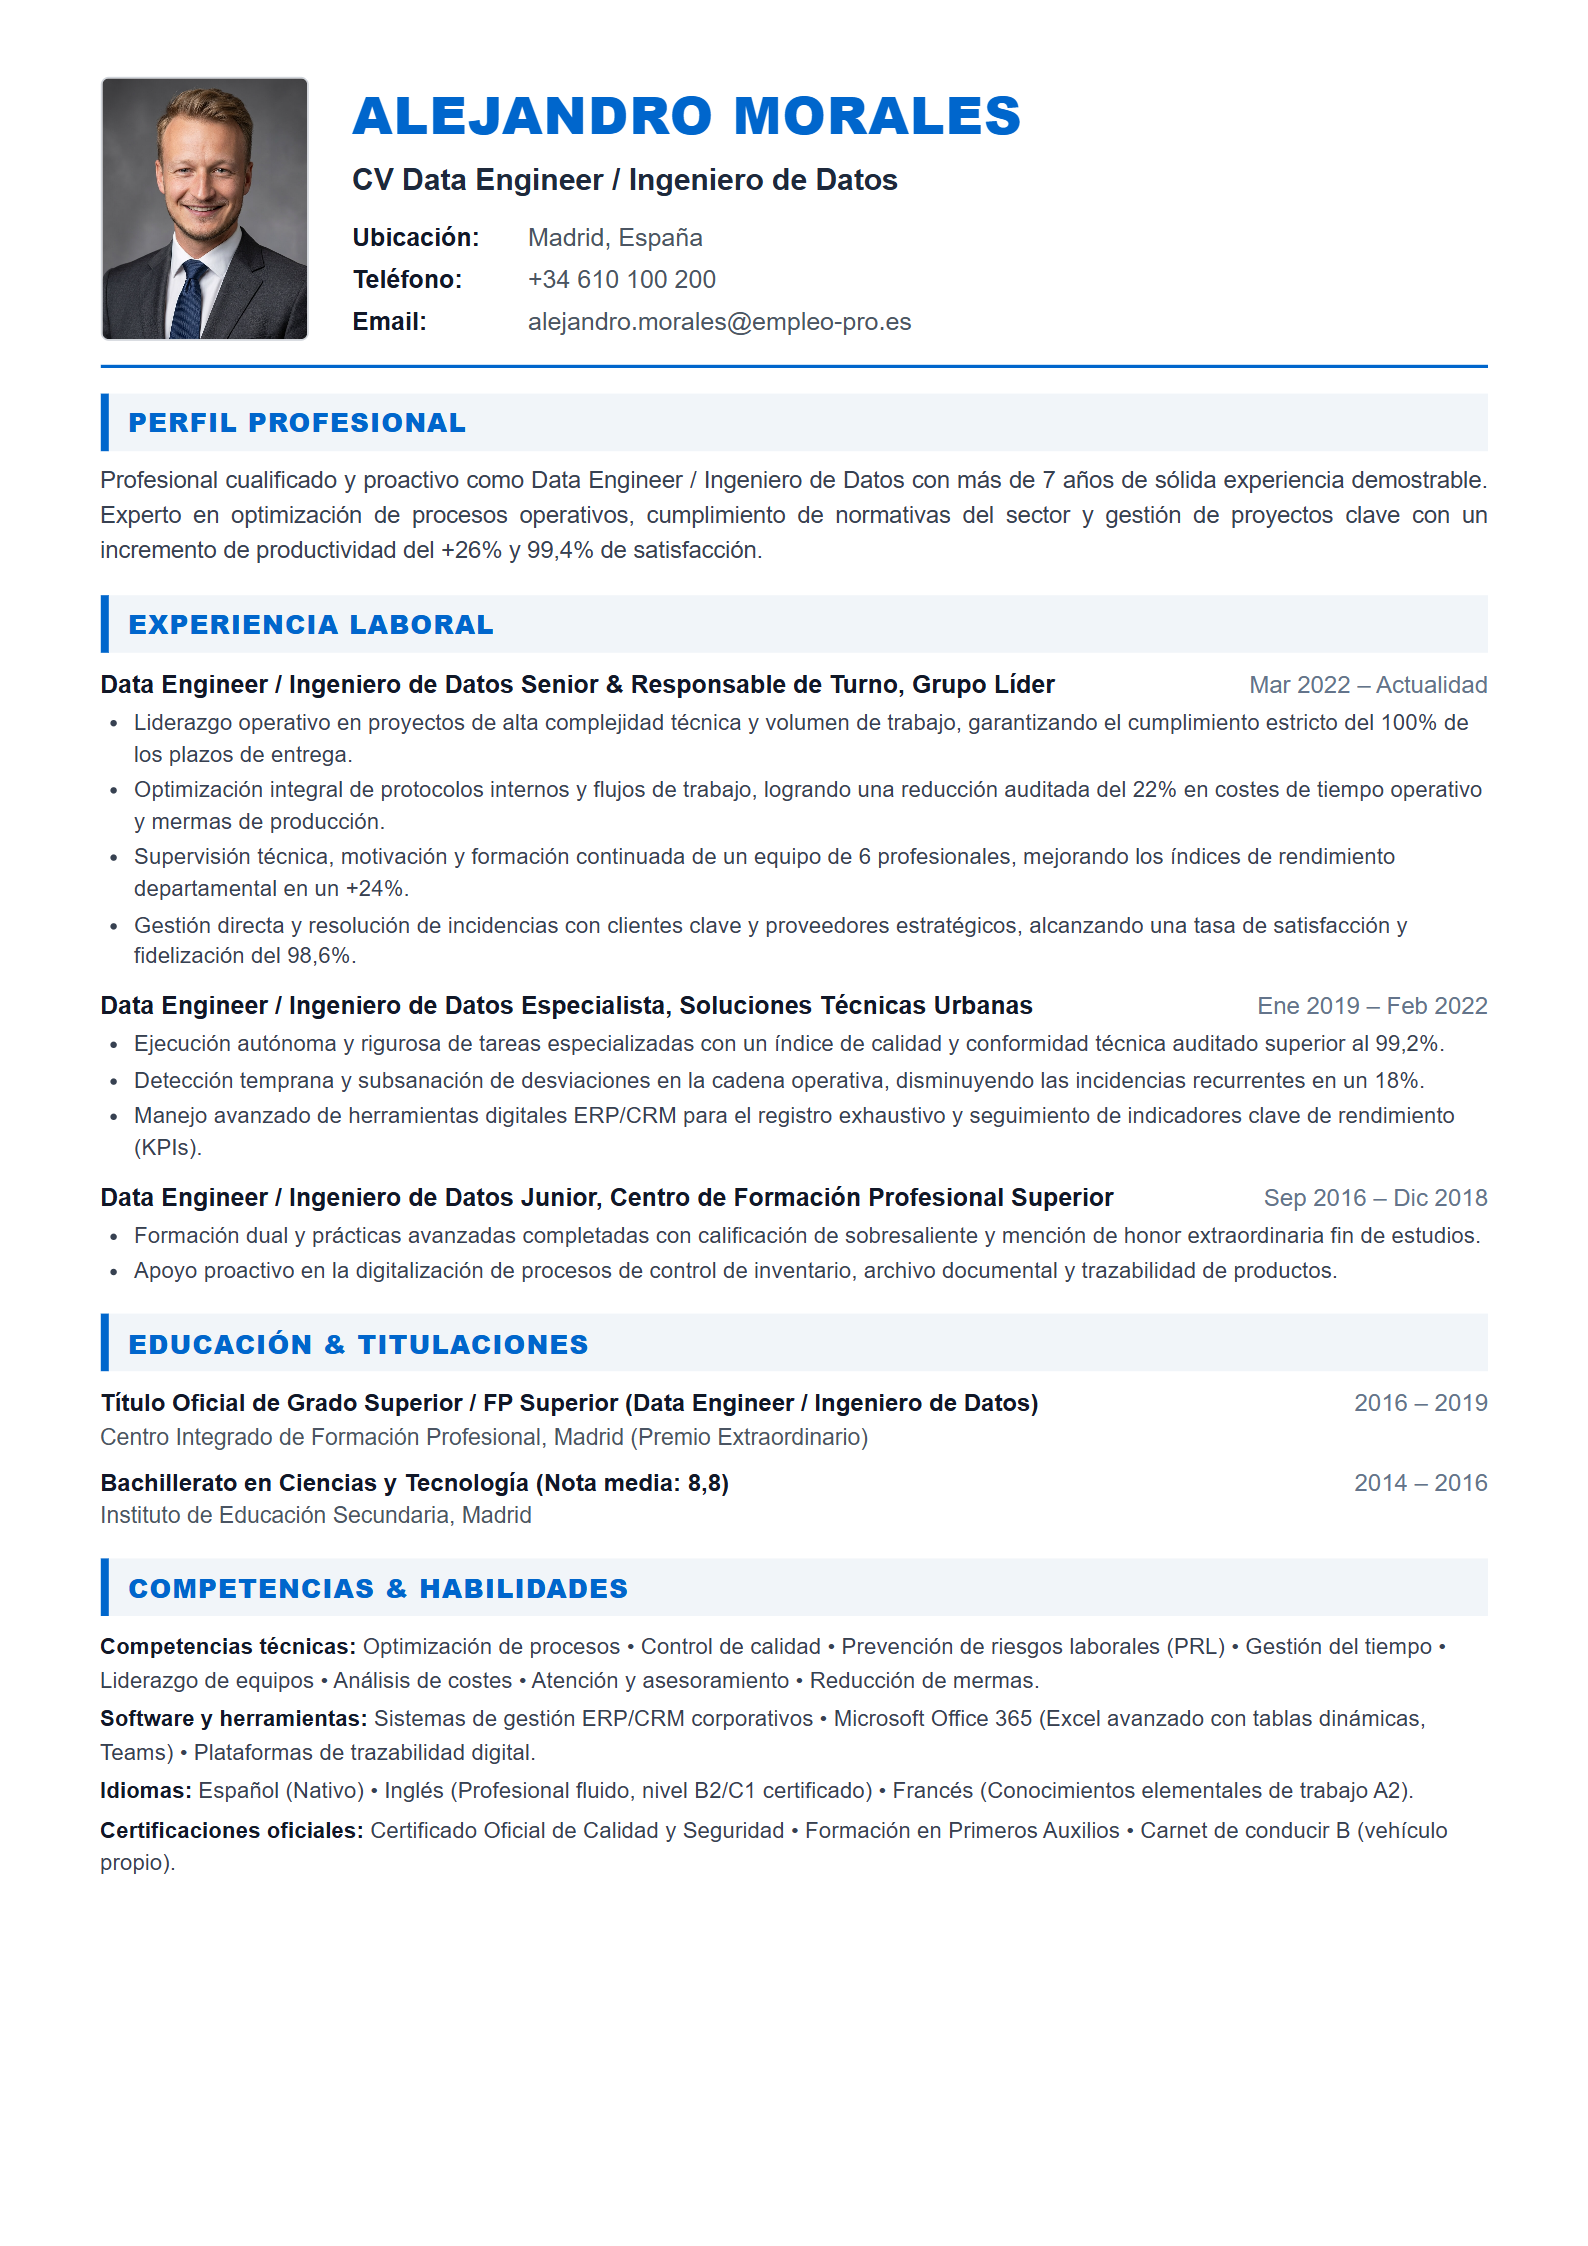
ALEJANDRO MORALES
DATA ENGINEER / INGENIERO DE DATOS
Dirección: Madrid, España, España
Teléfono: +34 610 100 200
Email: alejandro.morales@empleo-pro.es

PERFIL PROFESIONAL
Data Engineer / Ingeniero de Datos cualificado y comprometido con más de 7 años de experiencia profesional demostrable. Especializado en la ejecución de proyectos complejos, aseguramiento de la calidad y coordinación de equipos técnicos conforme a las exigencias normativas del sector.
Ingeniero de Datos Senior | Banco Santander Digital, Madrid, España
Mar 2022 – Actualidad
• Diseño e implementación de pipelines de streaming en PySpark y Kafka procesando 4,2 TB/día, reduciendo la latencia de ingestión de 45 min a menos de 30 segundos.
• Dirección técnica de proyectos clave, validación de especificaciones y coordinación del equipo de trabajo en el terreno.

Desarrollador de Pipelines Big Data | Glovo, Madrid, España
Ene 2019 – Feb 2022
• Migración integral de DWH legacy a Snowflake mediante dbt y Airflow, recortando costes cloud en un 31% y respaldando a más de 80 analistas y científicos de datos.
• Ejecución autónoma de tareas especializadas en Apache Spark & PySpark y Modelado SQL y NoSQL utilizando AWS (S3, EMR, Redshift, Glue) con altos estándares de calidad.

Data Engineer | Telefónica Tech, Madrid, España
Sep 2016 – Dic 2018
• Automatización de validaciones de calidad de datos con Great Expectations en CI/CD, evitando el 99,2% de errores de esquema en producción.
• Colaboración en pruebas técnicas y despliegues en Orquestación con Apache Airflow con seguimiento bajo Docker y Kubernetes y elaboración de documentación.
Máster Universitario en Ingeniería de Datos y Big Data
Universidad Politécnica de Madrid (UPM), Madrid | 2014 – 2016
Premio Extraordinario Fin de Ciclo • Calificación Media: 9,4

Grado en Ingeniería Informática
Universitat Politècnica de València (UPV), Madrid | 2012 – 2014
Ingeniería de Datos & Big Data: Apache Spark & PySpark, Modelado SQL y NoSQL, Orquestación con Apache Airflow, Streaming Kafka y Eventos, Snowflake y BigQuery DWH, Transformaciones con dbt, Arquitectura Data Lakehouse, Metodologías DataOps
Herramientas Cloud & Infraestructura: AWS (S3, EMR, Redshift, Glue), Google Cloud Platform (GCP), Docker y Kubernetes, Terraform (IaC), Databricks, GitLab CI y GitHub Actions
Certificaciones & Normativa: AWS Certified Data Engineer, Certificación Profesional Databricks Data Engineer, Snowflake SnowPro Core
Idiomas: Español (Nativo), Inglés (B2/C1 certificado), Carnet de conducir B
Competencias y Palabras Clave Estratégicas para 2026
Para superar los cribados automáticos de portales de empleo e IA de selección, integra estas palabras clave en tu perfil: