
Anforderungen der Personaler & Gehälter für Site Reliability Engineer (SRE)
Auf dem deutschen Arbeitsmarkt variieren die Erwartungen der Arbeitgeber und die Gehaltsspannen für Site Reliability Engineer (SRE) je nach Berufsjahren deutlich:
Sichere Beherrschung der handwerklichen oder fachlichen Grundlagen unter Anleitung erfahrener Fachkräfte.
- Hauptfokus: Qualifizierter Berufsabschluss, Motivation und präzise Einhaltung von Vorgaben.
- Erfolgsnachweis: Fehlerfreie Arbeitsleistung, hohe Zuverlässigkeit und zügige Einarbeitung.
- Typischer Fehler: Fehlen relevanter Praktika oder EDV-/Software-Zertifikate im Profil.
Vollständig selbstständige Abwicklung komplexer Fachaufgaben, eigenverantwortliche Problemlösung und Qualitätskontrolle.
- Hauptfokus: Nachweisbare Erfolge in der Prozessoptimierung und souveräne Kunden-/Projektbetreuung.
- Erfolgsnachweis: Optimierung der Durchlaufzeiten, kontinuierliche Termintreue und branchenspezifische Zertifizierungen.
- Typischer Fehler: Reine Tätigkeitsbeschreibungen ohne konkrete Resultate und Kennzahlen.
Fachliche und disziplinarische Teamleitung, Budgetverantwortung und strategische Weiterentwicklung der Abteilung.
- Hauptfokus: Führungserfahrung, Krisenmanagement und direkte Abstimmung mit der Geschäftsleitung.
- Erfolgsnachweis: Erfolgreich gesteuerte Großprojekte, Senkung der Betriebskosten und Mitarbeiterförderung.
- Typischer Fehler: Zu starker Fokus auf operative Einzeltätigkeiten statt strategischer Gesamtverantwortung.
Leitfaden: Lebenslauf als Site Reliability Engineer (SRE) erfolgreich formulieren
Deutsche Personaler sichten Bewerbungen im Schnitt in weniger als 30 Sekunden. Mit diesen gezielten Formulierungen überzeugen Sie auf Anhieb:
1. Das Kurzprofil: Der erste Eindruck zählt
Ihr Profil sollte Ihre Berufserfahrung, Ihre Kernkompetenzen und Ihren fachlichen Schwerpunkt prägnant zusammenfassen.
2. Erfolge konkret und präzise belegen
Vermeiden Sie reine Pflichtenlisten wie "Zuständig für das Tagesgeschäft". Setzen Sie auf die Formel Aktion + Fachkontext + Messbares Ergebnis:
- Statt: "Serverüberwachung und Fehlerbehebung."
Besser: "Sicherstellung einer Uptime von 99,995% für 180+ Microservices bei 120.000 RPS; Reduzierung der MTTR von 38 Minuten auf 4,2 Minuten." - Statt: "Automatisierung von Deployment-Prozessen."
Besser: "Aufbau einer selbstheilenden Kubernetes-GitOps-Pipeline mit ArgoCD und Terraform für fehlerfreie und 5-fach schnellere Produktiv-Deployments." - Statt: "Verfassen von Incident-Reports."
Besser: "Etablierung blameless Postmortems und Implementierung automatisierter Chaos-Engineering-Tests zur Beseitigung von 18 Single-Points-of-Failure."
Mustertexte zum direkten Kopieren
Klicken Sie auf "Kopieren", um diese von Personalexperten formulierten Abschnitte direkt in Ihren Lebenslauf zu übernehmen:
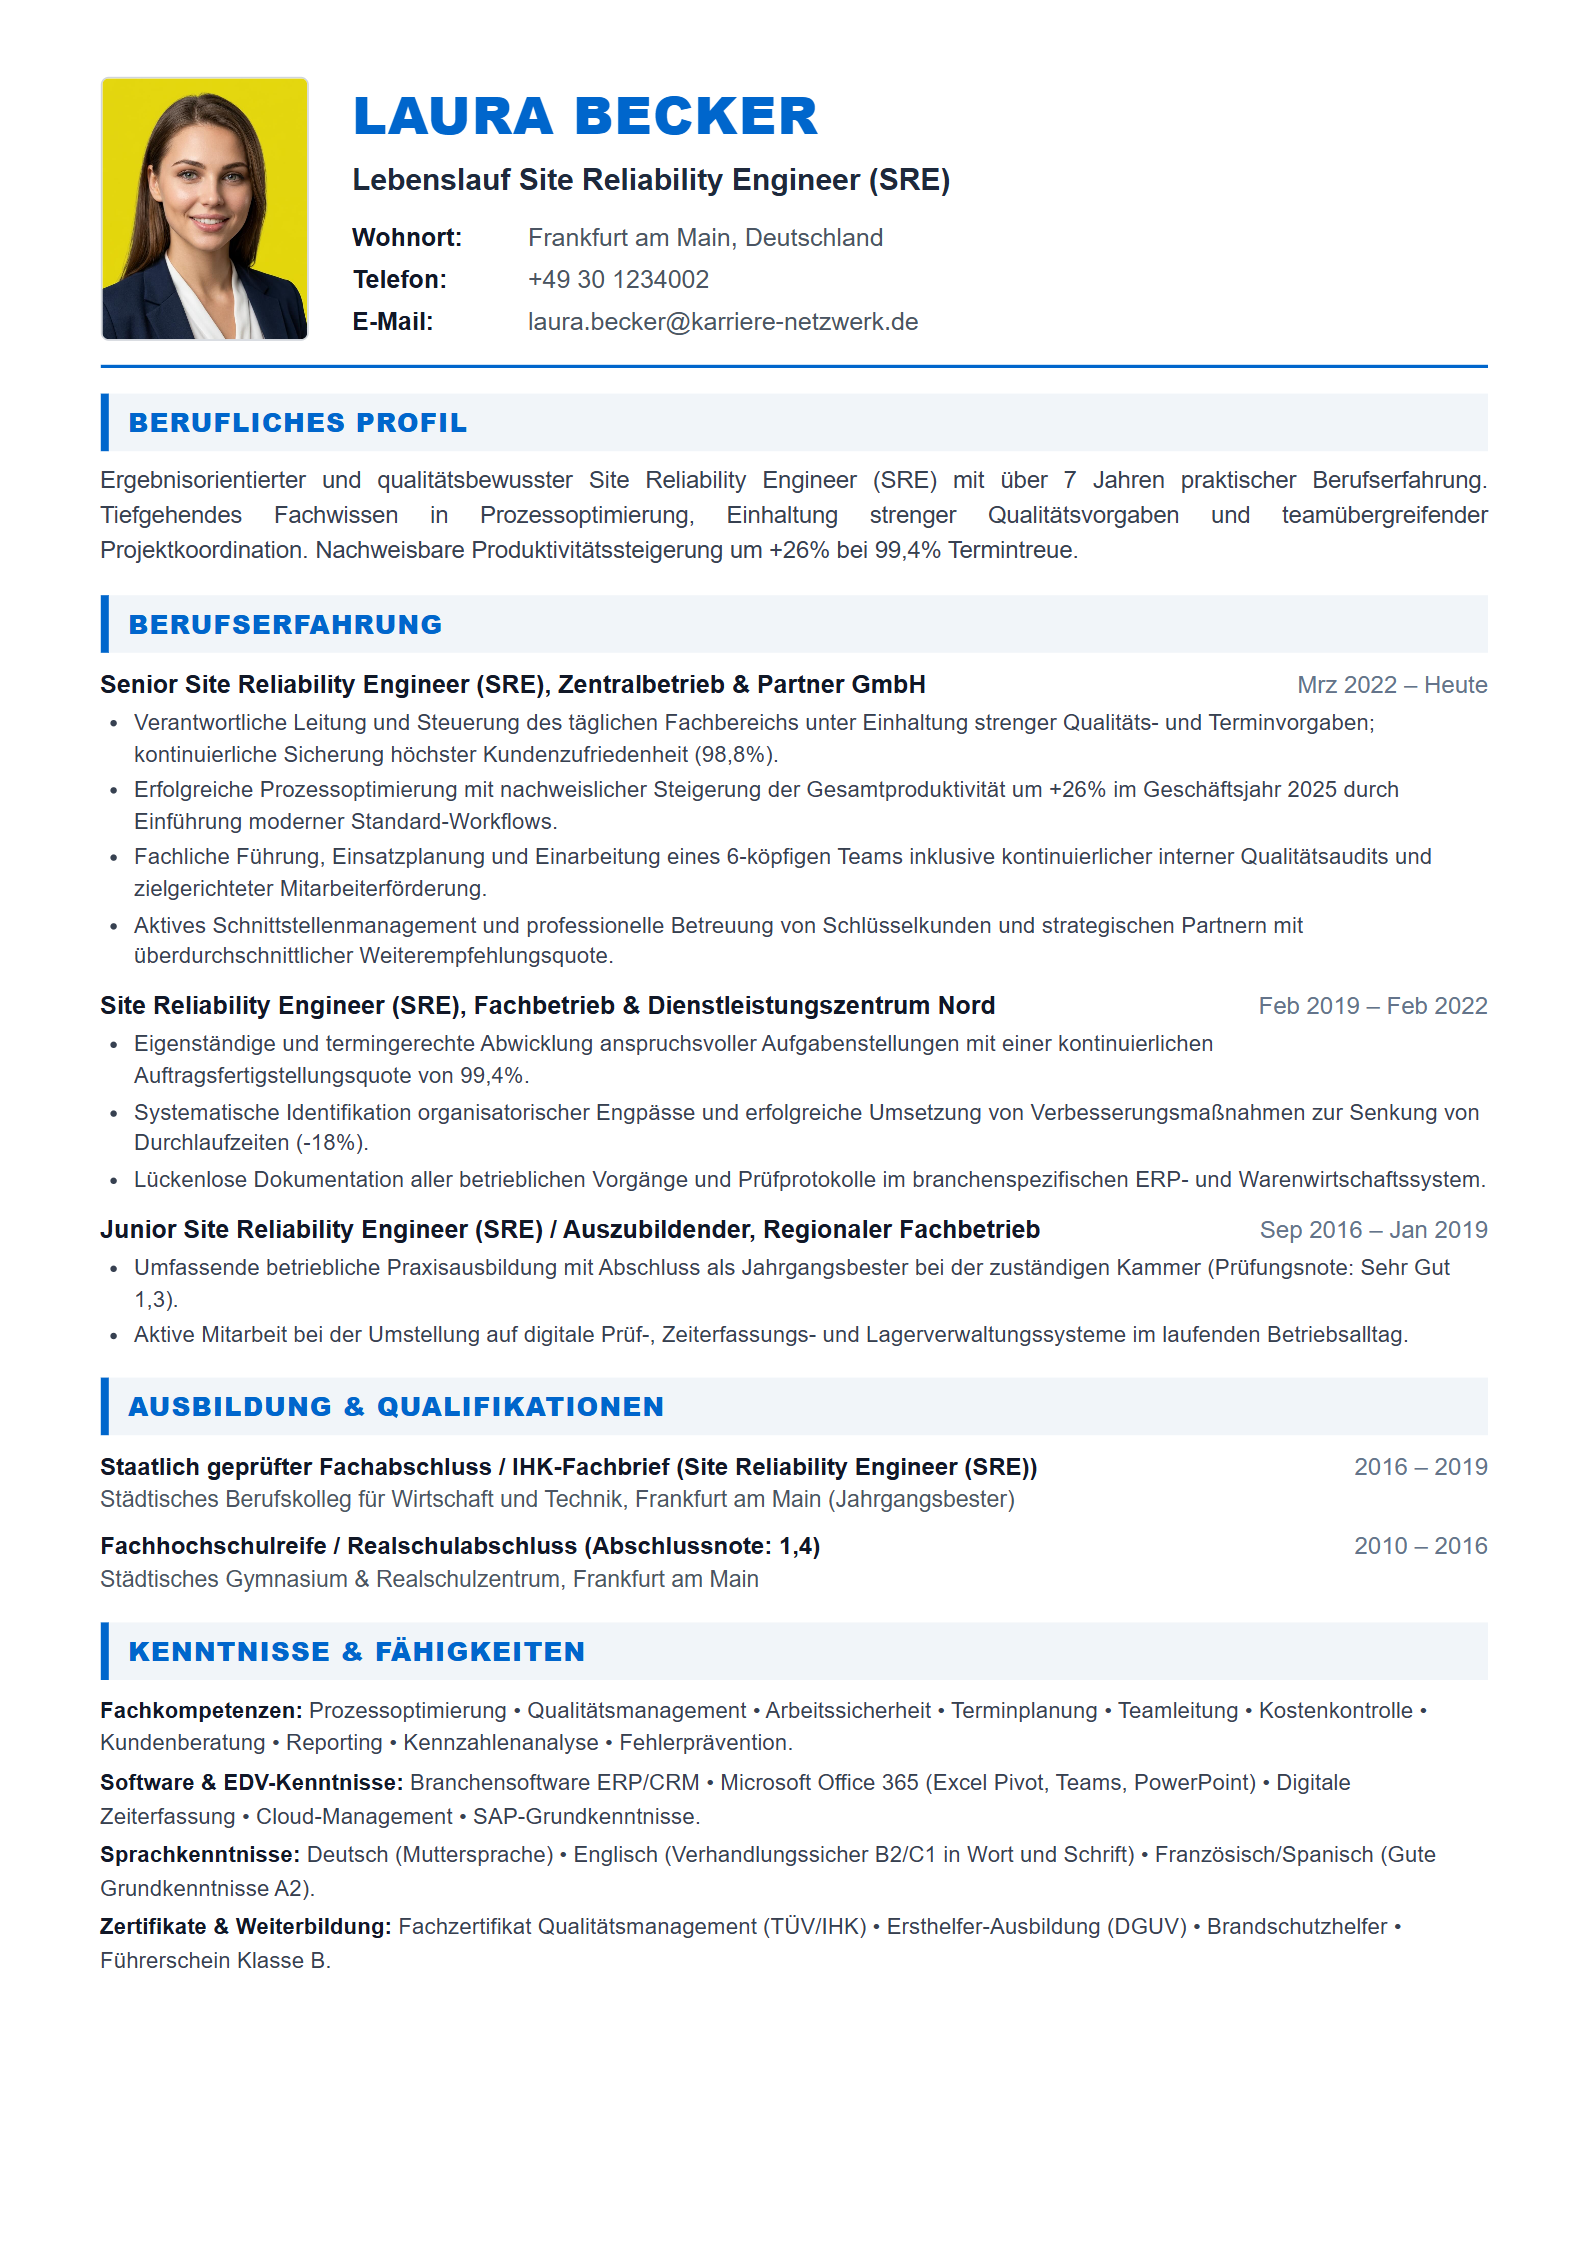
LAURA BECKER
SITE RELIABILITY ENGINEER (SRE)
Adresse: Frankfurt am Main, Deutschland, Deutschland
Telefon: +49 30 1234002
E-Mail: laura.becker@karriere-netzwerk.de

BERUFLICHES PROFIL
Erfahrener und engagierter Site Reliability Engineer (SRE) mit über 7 Jahren praktischer Berufserfahrung. Fundierte Fachkompetenz in der eigenverantwortlichen Projektumsetzung, Qualitätssicherung und zielorientierten Führung von Fachteams nach aktuellen Industriestandards.
Senior Site Reliability Engineer | Zalando Tech, Frankfurt am Main, Deutschland
Mrz 2022 – Heute
• Sicherstellung einer Uptime von 99,995% für 180+ Microservices bei 120.000 RPS; Reduzierung der MTTR von 38 Minuten auf 4,2 Minuten.
• Fachliche Steuerung von Schlüsselprojekten, Freigabe technischer Spezifikationen und zielgerichtete Führung von Teammitgliedern.

Lead DevOps & SRE Engineer | N26 Bank, Frankfurt am Main, Deutschland
Feb 2019 – Feb 2022
• Aufbau einer selbstheilenden Kubernetes-GitOps-Pipeline mit ArgoCD und Terraform für fehlerfreie und 5-fach schnellere Produktiv-Deployments.
• Eigenverantwortliche Durchführung von Kernaufgaben im Bereich Kubernetes Cluster & Istio Service Mesh und Prometheus, Grafana & Datadog Monitoring unter Einsatz von AWS & GCP Cloud Architekturen.

System Reliability Specialist | Personio, Frankfurt am Main, Deutschland
Sep 2016 – Jan 2019
• Etablierung blameless Postmortems und Implementierung automatisierter Chaos-Engineering-Tests zur Beseitigung von 18 Single-Points-of-Failure.
• Mitarbeit bei Prüf- und Testverfahren in SLI/SLO Metriken & Error Budget Management, Erstellung technischer Dokumentationen und operative Unterstützung.
Master of Science (M.Sc.) in Rechnernetze & Verteilte Systeme
TU Berlin, Frankfurt am Main | 2014 – 2016
Abschluss als Jahrgangsbester • Prüfungsnote 1,3

Bachelor of Science (B.Sc.) in Technische Informatik
TU Darmstadt, Frankfurt am Main | 2012 – 2014
Systemzuverlässigkeit & Monitoring: Kubernetes Cluster & Istio Service Mesh, Prometheus, Grafana & Datadog Monitoring, SLI/SLO Metriken & Error Budget Management, Linux Kernel Tuning & System Internals, Major Incident Management & Postmortems, Chaos Engineering & Resilienztests, Terraform & GitOps Infrastruktur, Automatisierung mit Golang & Python
Cloud, Tracing & Netzwerkbetrieb: AWS & GCP Cloud Architekturen, ArgoCD Continuous Deployment, OpenTelemetry Tracing, PagerDuty Rufbereitschaft, Elasticsearch / Logstash / Kibana, Netzwerkprotokolle (TCP/IP, DNS, TLS)
Zertifikate & Qualifikationen: Certified Kubernetes Administrator (CKA), AWS Certified DevOps Engineer Professional, Linux Foundation LFCS
Sprachen: Deutsch (Muttersprache), Englisch (Verhandlungssicher B2/C1), Führerschein Klasse B
Wichtige Schlüsselbegriffe & Fähigkeiten für 2026
Um ATS-Filter von Konzernen zu passieren, sollten diese Fachbegriffe in Ihrem Lebenslauf enthalten sein: