
Anforderungen der Personaler & Gehälter für Data Engineer / Big Data Ingenieur
Auf dem deutschen Arbeitsmarkt variieren die Erwartungen der Arbeitgeber und die Gehaltsspannen für Data Engineer / Big Data Ingenieur je nach Berufsjahren deutlich:
Sichere Beherrschung der handwerklichen oder fachlichen Grundlagen unter Anleitung erfahrener Fachkräfte.
- Hauptfokus: Qualifizierter Berufsabschluss, Motivation und präzise Einhaltung von Vorgaben.
- Erfolgsnachweis: Fehlerfreie Arbeitsleistung, hohe Zuverlässigkeit und zügige Einarbeitung.
- Typischer Fehler: Fehlen relevanter Praktika oder EDV-/Software-Zertifikate im Profil.
Vollständig selbstständige Abwicklung komplexer Fachaufgaben, eigenverantwortliche Problemlösung und Qualitätskontrolle.
- Hauptfokus: Nachweisbare Erfolge in der Prozessoptimierung und souveräne Kunden-/Projektbetreuung.
- Erfolgsnachweis: Optimierung der Durchlaufzeiten, kontinuierliche Termintreue und branchenspezifische Zertifizierungen.
- Typischer Fehler: Reine Tätigkeitsbeschreibungen ohne konkrete Resultate und Kennzahlen.
Fachliche und disziplinarische Teamleitung, Budgetverantwortung und strategische Weiterentwicklung der Abteilung.
- Hauptfokus: Führungserfahrung, Krisenmanagement und direkte Abstimmung mit der Geschäftsleitung.
- Erfolgsnachweis: Erfolgreich gesteuerte Großprojekte, Senkung der Betriebskosten und Mitarbeiterförderung.
- Typischer Fehler: Zu starker Fokus auf operative Einzeltätigkeiten statt strategischer Gesamtverantwortung.
Leitfaden: Lebenslauf als Data Engineer / Big Data Ingenieur erfolgreich formulieren
Deutsche Personaler sichten Bewerbungen im Schnitt in weniger als 30 Sekunden. Mit diesen gezielten Formulierungen überzeugen Sie auf Anhieb:
1. Das Kurzprofil: Der erste Eindruck zählt
Ihr Profil sollte Ihre Berufserfahrung, Ihre Kernkompetenzen und Ihren fachlichen Schwerpunkt prägnant zusammenfassen.
2. Erfolge konkret und präzise belegen
Vermeiden Sie reine Pflichtenlisten wie "Zuständig für das Tagesgeschäft". Setzen Sie auf die Formel Aktion + Fachkontext + Messbares Ergebnis:
- Statt: "Erstellung von Datenpipelines und Datenbankabfragen."
Besser: "Entwicklung hochskalierbarer PySpark- & Kafka-Streaming-Pipelines für 4,2 TB täglich; Senkung der Ingestionslatenz von 45 Min. auf unter 30 Sekunden." - Statt: "Wartung des Data Warehouses für Analysten."
Besser: "Erfolgreiche Migration des Legacy-DWH zu Snowflake via dbt und Airflow, wodurch 31% Cloud-Kosten eingespart und 80+ interne BI-Stakeholder unterstützt wurden." - Statt: "Behebung von Fehlern in Datenflüssen."
Besser: "Einführung automatisierter Datenqualitätsprüfungen mit Great Expectations in CI/CD zur Eliminierung von 99,2% aller Schema-Inkonsistenzen."
Mustertexte zum direkten Kopieren
Klicken Sie auf "Kopieren", um diese von Personalexperten formulierten Abschnitte direkt in Ihren Lebenslauf zu übernehmen:
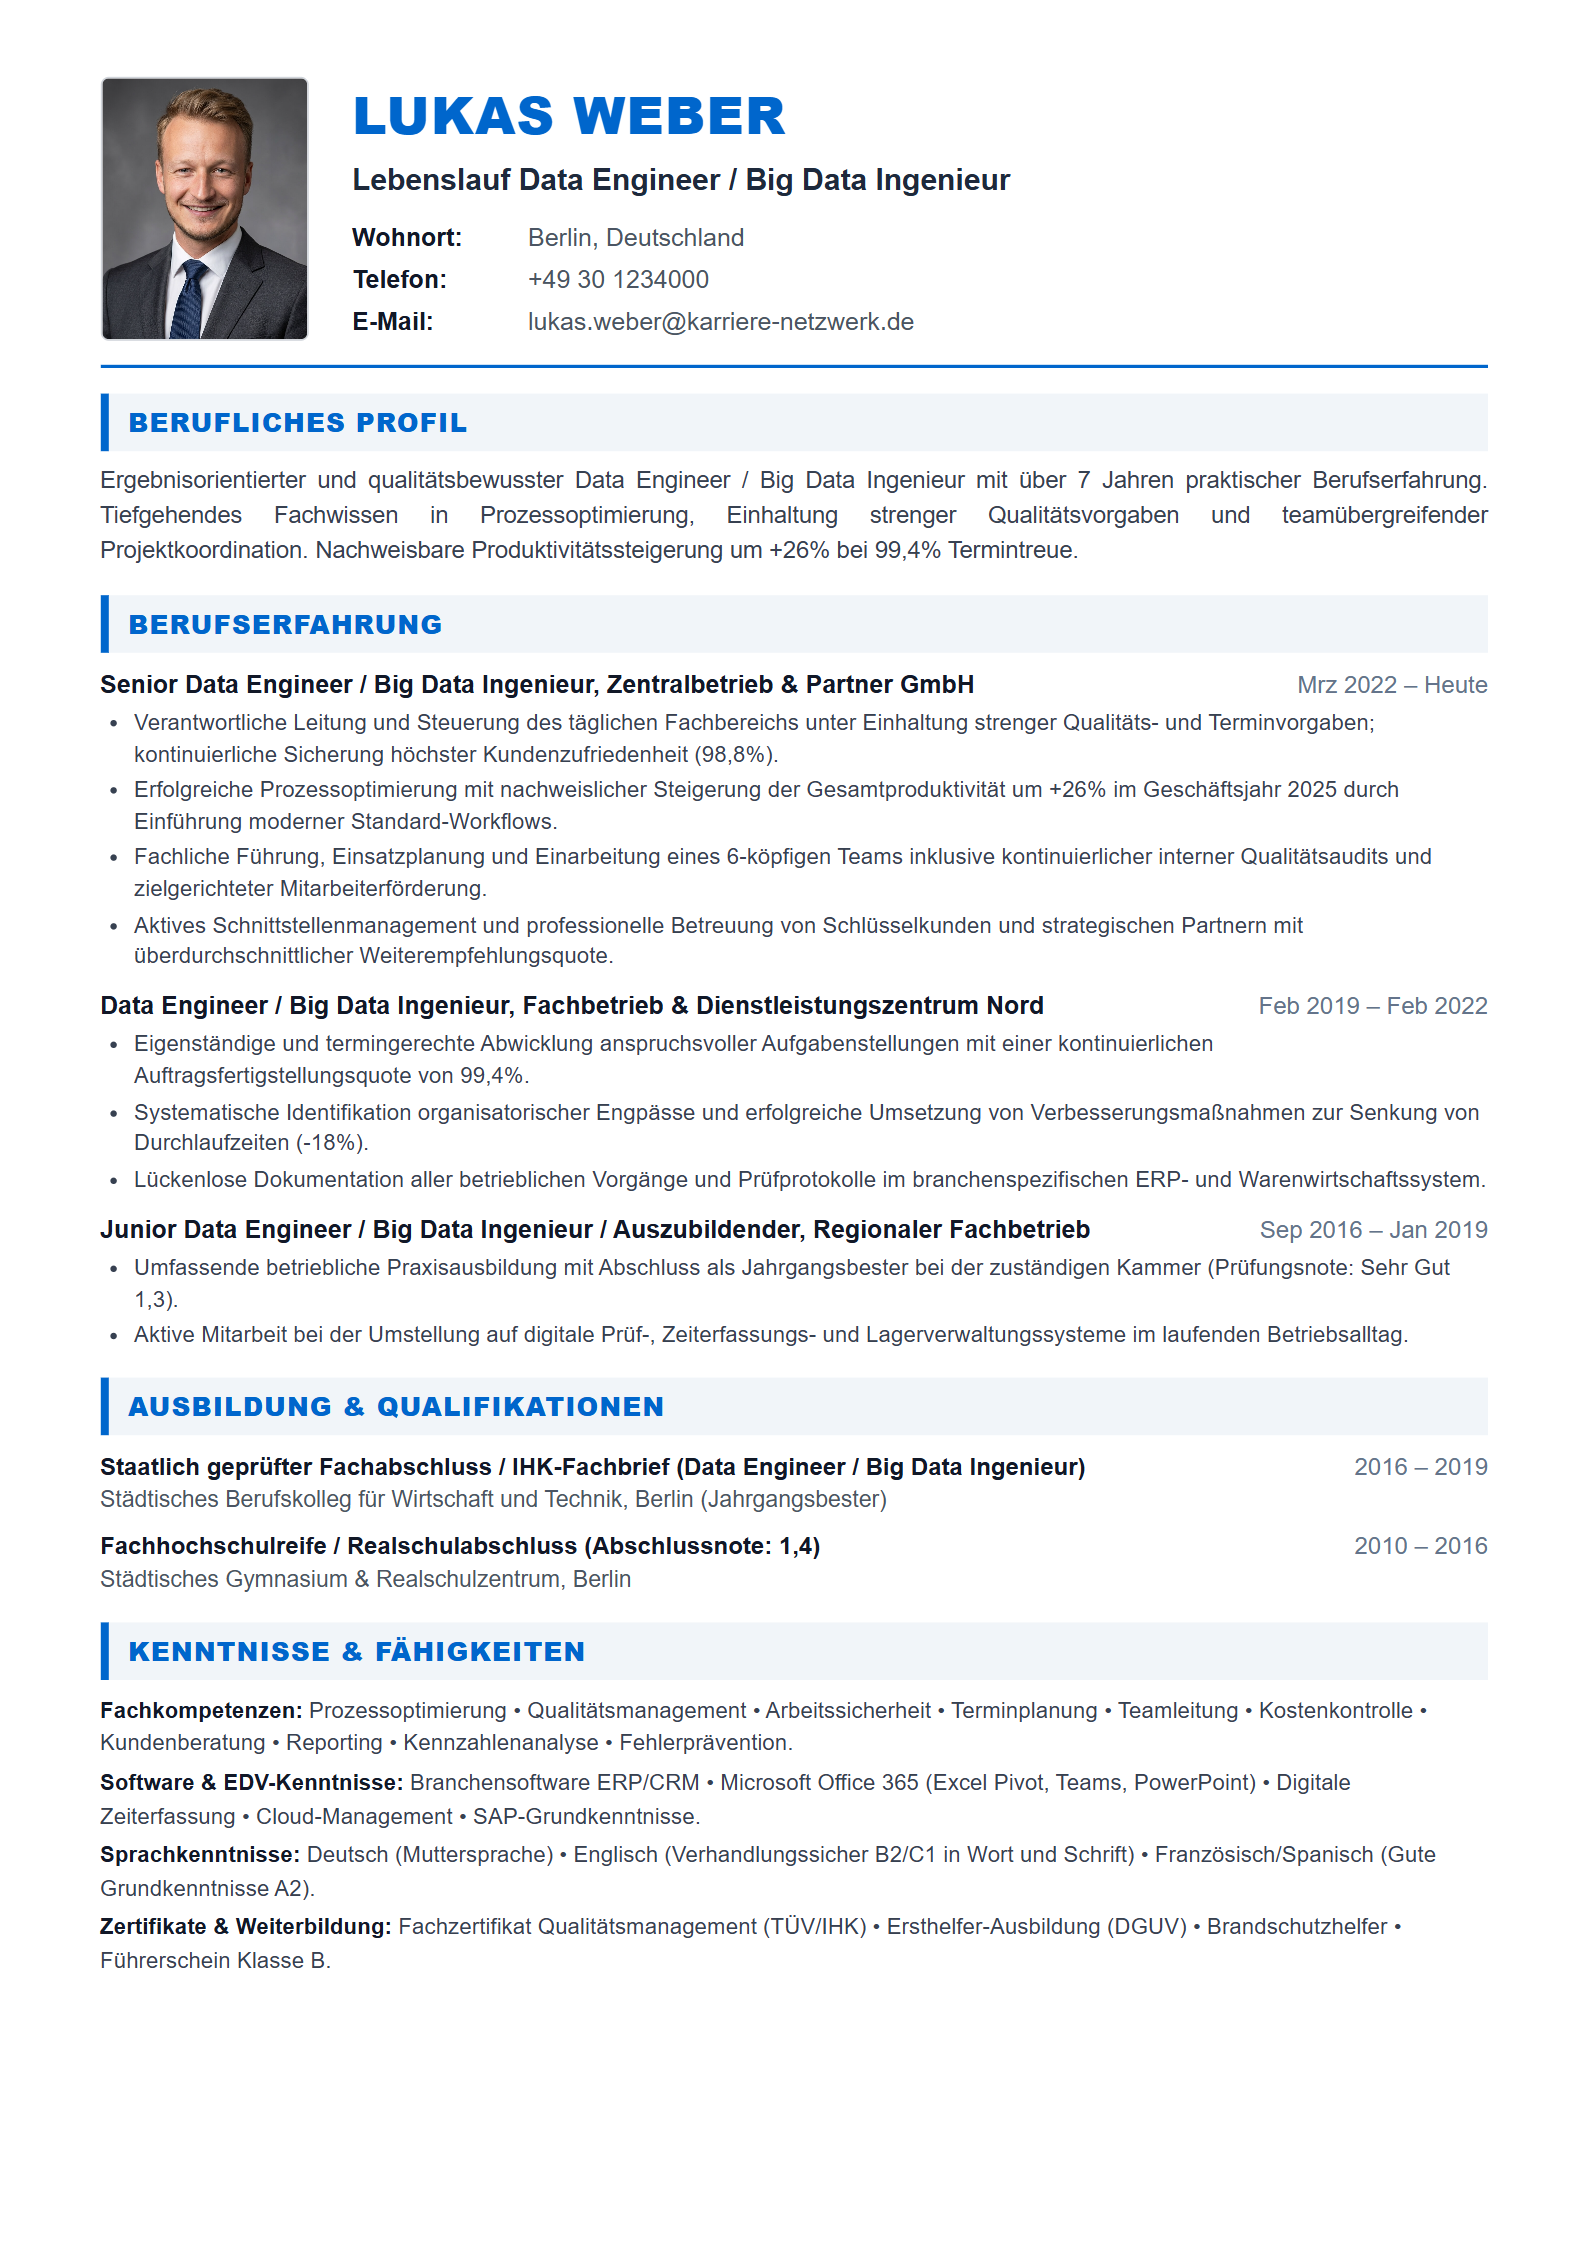
LUKAS WEBER
DATA ENGINEER / BIG DATA INGENIEUR
Adresse: Berlin, Deutschland, Deutschland
Telefon: +49 30 1234000
E-Mail: lukas.weber@karriere-netzwerk.de

BERUFLICHES PROFIL
Erfahrener und engagierter Data Engineer / Big Data Ingenieur mit über 7 Jahren praktischer Berufserfahrung. Fundierte Fachkompetenz in der eigenverantwortlichen Projektumsetzung, Qualitätssicherung und zielorientierten Führung von Fachteams nach aktuellen Industriestandards.
Senior Data Engineer | Zalando SE, Berlin, Deutschland
Mrz 2022 – Heute
• Entwicklung hochskalierbarer PySpark- & Kafka-Streaming-Pipelines für 4,2 TB täglich; Senkung der Ingestionslatenz von 45 Min. auf unter 30 Sekunden.
• Fachliche Steuerung von Schlüsselprojekten, Freigabe technischer Spezifikationen und zielgerichtete Führung von Teammitgliedern.

Big Data Architekt | Delivery Hero SE, Berlin, Deutschland
Feb 2019 – Feb 2022
• Erfolgreiche Migration des Legacy-DWH zu Snowflake via dbt und Airflow, wodurch 31% Cloud-Kosten eingespart und 80+ interne BI-Stakeholder unterstützt wurden.
• Eigenverantwortliche Durchführung von Kernaufgaben im Bereich Apache Spark & PySpark und SQL & Datenmodellierung unter Einsatz von AWS (Redshift, Glue, EMR).

Data Pipeline Spezialist | BMW Group IT, Berlin, Deutschland
Sep 2016 – Jan 2019
• Einführung automatisierter Datenqualitätsprüfungen mit Great Expectations in CI/CD zur Eliminierung von 99,2% aller Schema-Inkonsistenzen.
• Mitarbeit bei Prüf- und Testverfahren in Airflow Pipeline-Orchestrierung, Erstellung technischer Dokumentationen und operative Unterstützung.
Master of Science (M.Sc.) in Informatik & Data Science
Technische Universität München (TUM), Berlin | 2014 – 2016
Abschluss als Jahrgangsbester • Prüfungsnote 1,3

Bachelor of Science (B.Sc.) in Praktischer Informatik
Karlsruher Institut für Technologie (KIT), Berlin | 2012 – 2014
Data Engineering & Big Data Architekturen: Apache Spark & PySpark, SQL & Datenmodellierung, Airflow Pipeline-Orchestrierung, Kafka Event-Streaming, Snowflake & BigQuery DWH, dbt Transformationen, Data Lakehouse Architektur, DataOps Best Practices
Cloud & DevOps Technologien: AWS (Redshift, Glue, EMR), Google Cloud Plattform (GCP), Docker & Kubernetes, Terraform (IaC), Databricks, Git & CI/CD Automatisierung
Zertifikate & Qualifikationen: AWS Certified Data Engineer, Databricks Certified Data Engineer Professional, Snowflake SnowPro Core
Sprachen: Deutsch (Muttersprache), Englisch (Verhandlungssicher B2/C1), Führerschein Klasse B
Wichtige Schlüsselbegriffe & Fähigkeiten für 2026
Um ATS-Filter von Konzernen zu passieren, sollten diese Fachbegriffe in Ihrem Lebenslauf enthalten sein: